Documentação do Broker v1
Fila de integração assíncrona com múltiplos endpoints externos — PostgreSQL + pg-boss, circuit breaker, rate limiting e escalonamento horizontal de workers com atribuição por fila.
Atualizada junto com o código — ver Sobre esta documentaçãoO que é o broker
O broker é um serviço de integração assíncrona baseada em fila: eventos são enfileirados no Postgres (via pg-boss, sem Redis/RabbitMQ/Kafka) e processados por um ou mais processos worker, que chamam uma API externa por HTTP, com retry/backoff nativos, circuit breaker e rate limiting próprios.
Desde a versão atual, o broker suporta múltiplos endpoints externos ao mesmo tempo — cada integração tem sua própria fila, credencial, circuit breaker e rate limiter, isolados uns dos outros. Um dashboard web dá visão em tempo real (SSE) de todas as filas, permite criar/editar endpoints, escalar workers e atribuir filas específicas a workers específicos.
Princípios de arquitetura
- Postgres como única fonte de verdade. Sem infraestrutura extra — a fila, o estado de circuit breaker, a configuração de endpoints e os logs estruturados moram todos no mesmo Postgres.
- Retry/backoff 100% nativos do pg-boss. O código da aplicação nunca reimplementa retry — só classifica erros (permanente vs. transitório) para decidir o que conta pro circuit breaker.
- Isolamento por endpoint. Cada integração externa tem fila, client HTTP, circuit breaker e rate limiter próprios — uma API externa degradada nunca consome a capacidade de processamento de outra.
- Live-reconfig sem restart. Endpoints, parâmetros, atribuição de filas por worker — tudo é lido de tabelas do Postgres e aplicado nos próximos ciclos de poll do worker, sem precisar reiniciar nada.
- Observabilidade em primeiro lugar. Todo estado relevante (fila, circuit breaker, workers vivos) é visível no dashboard em tempo real via Server-Sent Events.
Arquitetura de ambiente
Em desenvolvimento/produção local, tudo roda via docker-compose, numa rede privada
própria (broker_default), com um Postgres dedicado (não compartilhado com outras
aplicações).
broker_default, o navegador e a API externa ficam fora dela, e o motivo pelo qual o dashboard mantém um registro próprio de instâncias de worker em vez de confiar só no WORKER_CONTROL_URL.Serviços do docker-compose.yml
| Serviço | Imagem/Build | Réplicas | Porta publicada | Volume |
|---|---|---|---|---|
postgres | postgres:16-alpine | 1 (fixo) | POSTGRES_PORT → 5432 | broker_pgdata |
worker | docker/Dockerfile.worker | 1..N (--scale worker=N) | nenhuma (control server é interno) | broker_logs |
dashboard | docker/Dockerfile.dashboard | 1 | DASHBOARD_PORT → 8080 | broker_logs |
mock-api dev only | docker/Dockerfile.mock-api | 1 | MOCK_API_PORT → 8090 | — |
mock-api só existe no overlay docker-compose.dev.yml e recusa iniciar se NODE_ENV=production — nunca sobe junto com o compose principal por acidente.Subindo o ambiente completo
# stack de producao/uso normal (postgres + worker + dashboard)
docker-compose up -d --build

# + laboratorio de testes (mock-api)
docker compose -f docker-compose.yml -f docker-compose.dev.yml up -d --build

# escalando workers horizontalmente
docker-compose up -d --scale worker=3
Arquitetura de componentes
Fluxo de dados entre os componentes lógicos da aplicação (independente de estarem em containers separados ou não):
SKIP LOCKED, cada endpoint tem um runtime totalmente isolado dentro de cada worker.Worker por dentro (src/worker/)
| Arquivo | Responsabilidade |
|---|---|
index.js | Loop principal: sobe um runtime por endpoint habilitado, reconcilia jobs órfãos no boot, faz poll periódico de app_endpoints/atribuição de filas, heartbeat de instância, control server. |
processor.js | Processa um job: aplica rate limit, checa circuit breaker, chama a API externa, classifica erro (4xx permanente vs. 5xx/timeout transitório). |
circuitBreaker.js | Máquina de estados CLOSED/OPEN/HALF_OPEN em memória, por endpoint. |
rateLimiter.js | Janela deslizante de chamadas/segundo, por endpoint. |
concurrencyManager.js | Gerencia quantas assinaturas boss.work() ficam ativas, sem nunca ultrapassar o configurado durante uma mudança. |
instanceRegistry.js | Heartbeat da instância + atribuição de filas (app_worker_instances). |
controlServer.js | HTTP interno (pause/resume/status) usado pelo dashboard e pela console CLI. |
alerts.js | Alerta (log + webhook opcional) para backlog e jobs travados. |
Dashboard por dentro (src/dashboard/)
server.js— servidor HTTP com todas as rotas/api/*, SSE (/api/events), e serve os arquivos estáticos depublic/(incluindo esta página).queries.js— todas as consultas SQL de leitura empgboss.jobe tabelas auxiliares.public/index.html— SPA de uma página só (sem build step, sem framework), com todas as abas.
Tabelas do Postgres
| Tabela | Schema | Dono | Conteúdo |
|---|---|---|---|
job | pgboss | pg-boss | Fila real — um registro por job, uma fila (name) por endpoint. |
schedule, subscription, version | pgboss | pg-boss | Internos do pg-boss — só leitura na aba Tabelas. |
app_endpoints | público | broker | Configuração de cada integração externa (URL, credencial, limites). |
app_worker_instances | público | broker | Heartbeat + atribuição de filas de cada processo worker vivo. |
app_circuit_breaker_state | público | broker | Último estado publicado do circuit breaker de cada fila. |
app_config | público | broker | Parâmetros globais editáveis (alertas, intervalos do dashboard). |
app_logs | público | broker | Log estruturado (JSON) de worker e dashboard, fonte principal da aba Logs. |
Múltiplos endpoints
O broker integra com N endpoints externos ao mesmo tempo, cada um com sua
própria fila pg-boss (nomeada ${QUEUE_NAME}.<endpoint-id>),
credencial, circuit breaker, rate limiter e política de retry.
Limitação conhecida: tipos de credencial
O client HTTP manda um header estático por chamada — cobre API key, Bearer token e HTTP Basic (pré-codificado). Não cobre esquemas que exigem assinar o corpo por requisição (ex: HMAC) sem uma extensão pontual do client.
Escalonamento e workers
Duas dimensões de escala
- Vertical — aumentar
concurrencyde um endpoint (ao vivo, aba Admin). - Horizontal — múltiplas réplicas do processo worker (
docker-compose --scale worker=N,scripts/run-local.sh worker=N, ou o botão + na aba Arquitetura).
rateLimitMaxCalls e o circuit breaker são em memória, por processo — com N réplicas na mesma fila, o volume real contra a API externa pode chegar a rateLimitMaxCalls × N. Divida o limite pelo número de réplicas planejadas.Dedicar um worker a filas específicas
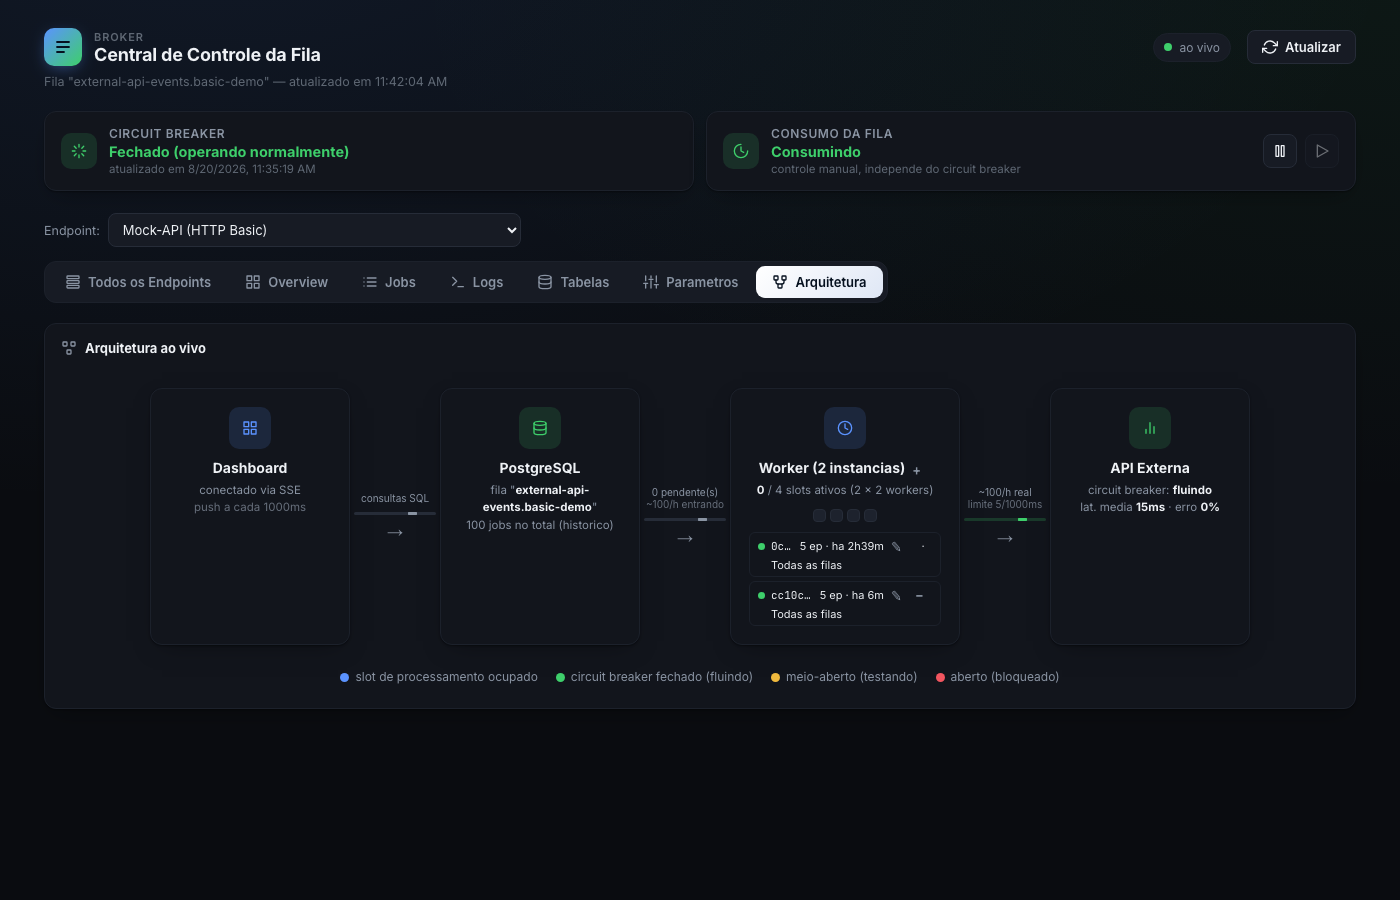
Por padrão todo worker consome todas as filas habilitadas. Pelo ícone de lápis (✎) no card de cada instância (aba Arquitetura), dá para desmarcar "Todas as filas" e escolher um subconjunto — o worker deixa de consumir as demais imediatamente (a atribuição é lida a cada ciclo de poll, sem restart), sem afetar circuit breaker/rate limiter das filas onde ele continua atuando, nem o consumo de outros workers.
A tabela "Todos os Endpoints" mostra quantos workers estão atribuídos a cada fila, com aviso se for 0 (fila parada) ou >1 (rate limit/circuit breaker multiplicado).
Instalação
Pré-requisitos
- Docker + Docker Compose (recomendado) ou Node.js 20+ para rodar nativo.
- Nenhum outro serviço já usando as portas escolhidas (por padrão 5544, 8080, 8090 — ajustável no
.env).
Passo a passo (Docker — recomendado)
git clone <repo> broker && cd broker
cp .env.example .env
# edite .env: senha do Postgres, credenciais de cada endpoint, etc.

docker-compose up -d --build
# abre o dashboard em http://localhost:8080
Rodando nativo (sem Docker)
npm install
cp .env.example .env
cp .env.example .env.local   # ajuste DATABASE_URL/EXTERNAL_API_URL para "localhost"

scripts/run-local.sh              # 1 worker + dashboard
scripts/run-local.sh worker=3     # 3 workers nativos
scripts/stop-local.sh # para tudo (nativo E docker-compose, se estiver rodando).env.example (postgres, mock-api) só resolvem dentro da rede do docker-compose. Rodando nativo, use .env.local (git-ignorado) com localhost — run-local.sh detecta e avisa se isso não estiver configurado.Criação do banco de dados
Não existe um script de migração para rodar manualmente — o schema é self-provisioning. Tanto o schema do pg-boss quanto as tabelas próprias da aplicação são criados sozinhos, automaticamente, na primeira vez que um processo sobe:
- Schema
pgboss(fila, agendamentos, versões) — criado pelo próprio pg-boss dentro deboss.start(), chamado no boot do worker, do dashboard e do console de controle. Não é código da aplicação. - Tabelas
app_*(endpoints, config, workers, circuit breaker, logs) — cada módulo chama seu próprioensure<X>Table()no boot, usando o helpercreateTableIfNotExists()desrc/config/db.js(CREATE TABLE IF NOT EXISTS, com proteção contra a corrida de duas sessões criando a mesma tabela ao mesmo tempo).
Ou seja: o "processo de criar o banco" é simplesmente subir a aplicação pela
primeira vez — não existe npm run migrate nem SQL para rodar à mão.
O que precisa existir antes disso é só a role e o database vazios:
Via Docker (automático)
A imagem oficial postgres:16-alpine já cria a role e
o database sozinha no primeiro boot do container, usando as variáveis do .env:
POSTGRES_USER=broker
POSTGRES_PASSWORD=change-me
POSTGRES_DB=broker_queue
Só acontece se o volume broker_pgdata estiver
vazio — depois da primeira vez, mudar essas variáveis não recria nada.
Postgres nativo/externo (manual)
Sem o Docker cuidando disso, crie a role e o database uma vez,
antes do primeiro npm run worker/dashboard:
psql -U postgres -c "CREATE ROLE broker WITH LOGIN PASSWORD 'change-me';"
psql -U postgres -c "CREATE DATABASE broker_queue OWNER broker;"
Aponte DATABASE_URL em .env.local
para esse database — o resto (schemas e tabelas) se cria sozinho no boot.
worker e dashboard ao mesmo tempo (ou várias
réplicas de worker) logo na primeira vez — o createTableIfNotExists() existe
justamente para resolver a corrida de duas sessões tentando criar a mesma tabela
simultaneamente (Postgres erro 23505), então não precisa subir um processo "primeiro" para
preparar o banco.Verificando a instalação
docker-compose ps— todos os serviçosUpepostgreshealthy.- Abrir
http://localhost:8080— deve carregar a tela "Todos os Endpoints". - Popular jobs de teste:
docker-compose exec worker node scripts/seed.js 10. - Confirmar no dashboard que os jobs aparecem e completam.
Manual de configuração
Duas camadas de configuração: variáveis de ambiente (infra/boot) e configuração dinâmica no Postgres, editável ao vivo pelo dashboard sem reiniciar nada.
Endpoints (por integração externa)
Cada endpoint é um registro em app_endpoints, gerenciado 100% pelo dashboard (aba
Parâmetros) ou pela API:
| Campo | Descrição |
|---|---|
id | Slug único (minúsculo, hifens) — vira o sufixo da fila. |
label | Nome amigável exibido no dashboard. |
baseUrl | URL HTTP (POST) da API externa. |
authHeaderName / authHeaderValue | Header estático de autenticação (API key, Bearer, Basic pré-codificado). O valor nunca é reexibido depois de salvo. |
timeoutMs | Timeout da chamada HTTP. |
concurrency | Assinaturas boss.work() paralelas por processo worker. |
rateLimitMaxCalls / rateLimitWindowMs | Limite de chamadas à API externa, por processo. |
circuitBreakerFailureThreshold / WindowMs / OpenMs | Limiares do circuit breaker. |
retryLimit / retryDelay / retryBackoff | Retry nativo do pg-boss — só vale para jobs enviados depois da mudança. |
enabled | Desativa o consumo sem apagar a configuração. |
GET    /api/endpoints
POST   /api/endpoints            { id, label, baseUrl, authHeaderName, authHeaderValue, ... }
PUT    /api/endpoints/:id        (parcial - so os campos enviados sao atualizados)
DELETE /api/endpoints/:id        (remove so a config; nao apaga jobs ja enfileirados)
Parâmetros globais
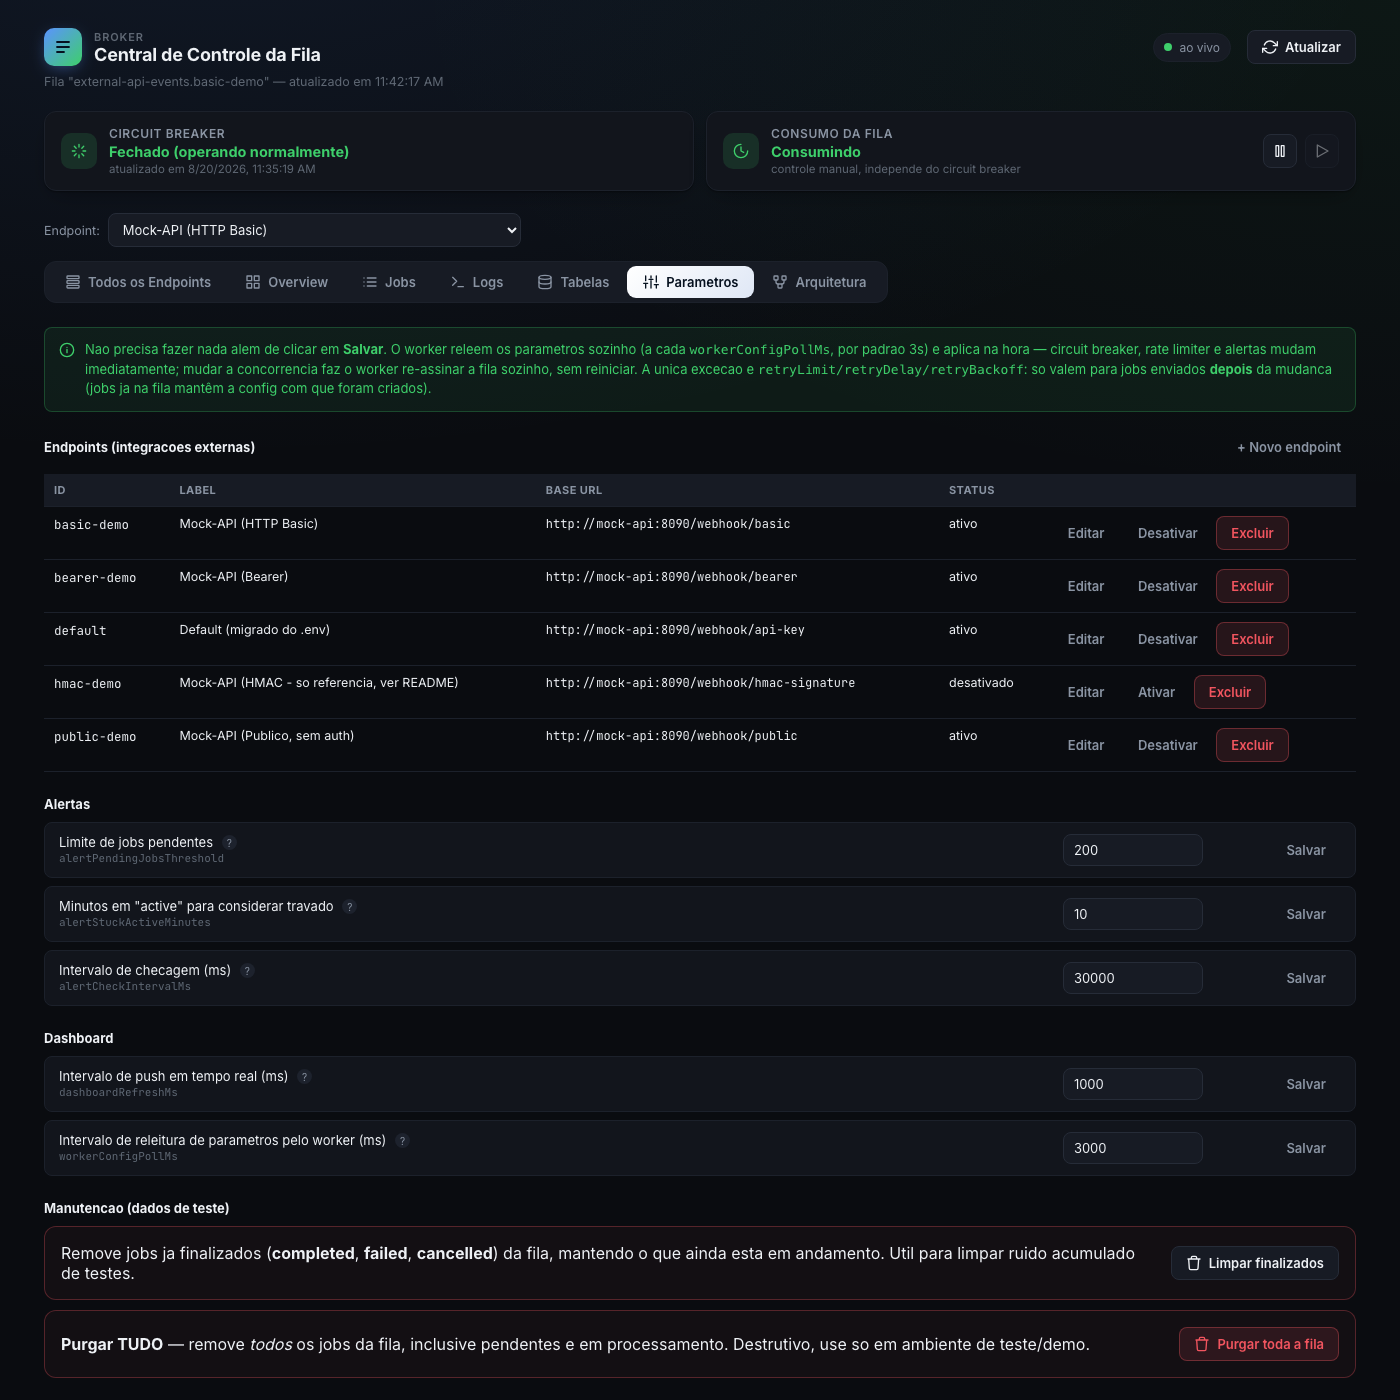
Editáveis na aba Parâmetros, aplicados ao vivo (releitura a cada workerConfigPollMs):
| Grupo | Campos |
|---|---|
| Alertas | alertPendingJobsThreshold, alertStuckActiveMinutes, alertCheckIntervalMs |
| Dashboard | dashboardRefreshMs (push SSE), workerConfigPollMs (releitura pelo worker) |
Variáveis de ambiente (.env)
Lista completa e comentada em .env.example. Principais grupos:
- Postgres:
POSTGRES_USER/PASSWORD/DB/PORT,DATABASE_URL - pg-boss:
QUEUE_NAME,PGBOSS_EXPIRE_IN_SECONDS,PGBOSS_MAINTENANCE_INTERVAL_SECONDS - Dashboard:
DASHBOARD_PORT - Worker:
WORKER_CONTROL_PORT,WORKER_CONTROL_URL - Laboratório de testes (dev):
MOCK_API_*
Como usar: enviando dados para a fila
Existem duas formas de enfileirar um evento. Para qualquer sistema externo (de qualquer linguagem), use a API HTTP de ingestão — é o caminho recomendado. Se o produtor já é um processo Node.js rodando dentro da mesma infraestrutura do broker, também é possível usar o cliente pg-boss diretamente (biblioteca), sem passar pela rede.
API HTTP de ingestão
POST /api/ingest/:endpointId, servida pelo mesmo processo do dashboard. O
corpo da requisição é exatamente o JSON que o worker vai enviar (via POST)
para o baseUrl configurado nesse endpoint — o broker não adiciona nem remove campos.
Passo a passo
- Cadastre o endpoint de destino (aba Admin ou
POST /api/endpoints) — é oiddesse registro que vira:endpointIdna URL. - Na mesma aba, clique em Gerar chave na coluna "Ingestão HTTP" desse endpoint. A chave aparece uma única vez — copie na hora.
- Chame a API mandando essa chave no header
X-Ingest-Key.
Contrato
| Item | Valor |
|---|---|
| Método/URL | POST /api/ingest/:endpointId |
| Headers obrigatórios | Content-Type: application/json, X-Ingest-Key: <chave> |
| Corpo | Objeto JSON qualquer (não pode ser array/string/número na raiz) — vira o payload enviado à API externa. |
| Sucesso | 202 Accepted — { "jobId": "...", "queueName": "..." } |
| Status | Quando | code |
|---|---|---|
| 400 | corpo não é JSON válido, ou não é um objeto na raiz | invalid_json / invalid_payload_shape |
| 401 | X-Ingest-Key ausente ou incorreta | invalid_ingest_key |
| 403 | endpoint desativado, ou sem chave de ingestão gerada ainda | endpoint_disabled / ingest_not_configured |
| 404 | endpointId não existe | endpoint_not_found |
| 413 | corpo maior que MAX_INGEST_BODY_BYTES (padrão 256KB) | payload_too_large |
| 415 | Content-Type não é application/json | unsupported_media_type |
Exemplo
curl -X POST https://seu-dominio/api/ingest/orders \
  -H "Content-Type: application/json" \
  -H "X-Ingest-Key: <chave gerada na aba Parametros>" \
  -d '{"orderId": "A-1029", "status": "paid", "total": 149.9}'

# 202 Accepted
# {"jobId":"9f2c...","queueName":"external-api-events.orders"}
Funciona de qualquer linguagem — só precisa fazer um POST com os dois headers.
Em Python, por exemplo:
import requests

requests.post(
    "https://seu-dominio/api/ingest/orders",
    headers={"X-Ingest-Key": "..."},
    json={"orderId": "A-1029", "status": "paid", "total": 149.9},
)X-Ingest-Key viajaria em texto claro pela
internet. Termine TLS num proxy reverso (Caddy, nginx) antes de aceitar tráfego de
produtores externos de verdade; o Node não deveria terminar TLS ele mesmo.
retryLimit/retryDelay/retryBackoff da aba
Parâmetros) — ao contrário do uso via biblioteca pg-boss abaixo, aqui não tem como
esquecer de passar essas opções.
Alternativa avançada: biblioteca pg-boss direto (só Node.js)
Se o produtor já é Node.js e prefere não depender de rede/HTTP (ex: outro processo dentro
da mesma infraestrutura, com acesso direto ao Postgres do broker), dá para inserir o job
direto na fila com o cliente pg-boss
— exatamente como scripts/seed.js e scripts/console.js já fazem.
Essa via não passa pela autenticação/limite de tamanho da API HTTP (é o mesmo nível de
confiança que o próprio worker).
import pg from 'pg';
import { env } from './src/config/env.js';
import { createBoss } from './src/config/pgboss.js';
import { queueNameFor, listEndpoints, buildEndpointSendOptions } from './src/config/endpoints.js';

const ENDPOINT_ID = 'orders'; // id cadastrado na aba Parametros

const pool = new pg.Pool({ connectionString: env.databaseUrl });
const [endpoint] = await listEndpoints(pool, { onlyEnabled: true })
  .then((rows) => rows.filter((e) => e.id === ENDPOINT_ID));
await pool.end();
if (!endpoint) throw new Error(`endpoint "${ENDPOINT_ID}" nao encontrado ou desativado`);

const boss = createBoss();
await boss.start();

const jobId = await boss.send(
  queueNameFor(endpoint.id),
  { orderId: 'A-1029', status: 'paid', total: 149.9 },
  buildEndpointSendOptions(endpoint), // aplica o retryLimit/retryDelay/backoff DESSE endpoint
);

console.log(`job ${jobId} enfileirado na fila ${queueNameFor(endpoint.id)}`);
await boss.stop();retryLimit/retryDelay/retryBackoff
no boss.send(), o pg-boss usa os defaults dele — não os
valores configurados para o endpoint no dashboard. Use buildEndpointSendOptions()
(ou copie os mesmos valores) para que o retry realmente siga a política daquele endpoint.Testando sem uma API real
Para popular filas com dados fake e validar o fluxo de ponta a ponta antes de conectar um produtor de verdade, use o script pronto (ver Laboratório de testes):
# popula TODOS os endpoints habilitados com 20 jobs cada
node scripts/seed.js 20

# popula so um endpoint especifico
node scripts/seed.js 20 orders
Laboratório de testes (mock-api)
Serviço à parte, só Node core, com 5 endpoints — um por tipo de credencial — que sorteiam sucesso/erro para exercitar circuit breaker, retry e rate limit sem depender de internet.
| Endpoint | Credencial |
|---|---|
POST /webhook/api-key | header X-Api-Key |
POST /webhook/bearer | Authorization: Bearer |
POST /webhook/basic | HTTP Basic |
POST /webhook/hmac-signature | HMAC do corpo — referência, não testável pelo client real |
POST /webhook/public | nenhuma |
⚠️ Nunca sobe em produção — só existe no overlay docker-compose.dev.yml.
Guia do dashboard
Tour pelas abas do dashboard, com screenshots reais da instância local. O ícone de sol/lua no cabeçalho alterna entre tema claro e escuro (preferência salva no navegador, detecta o tema do sistema operacional na primeira visita) — as capturas abaixo estão no tema escuro (padrão), mas toda a interface tem equivalente claro.
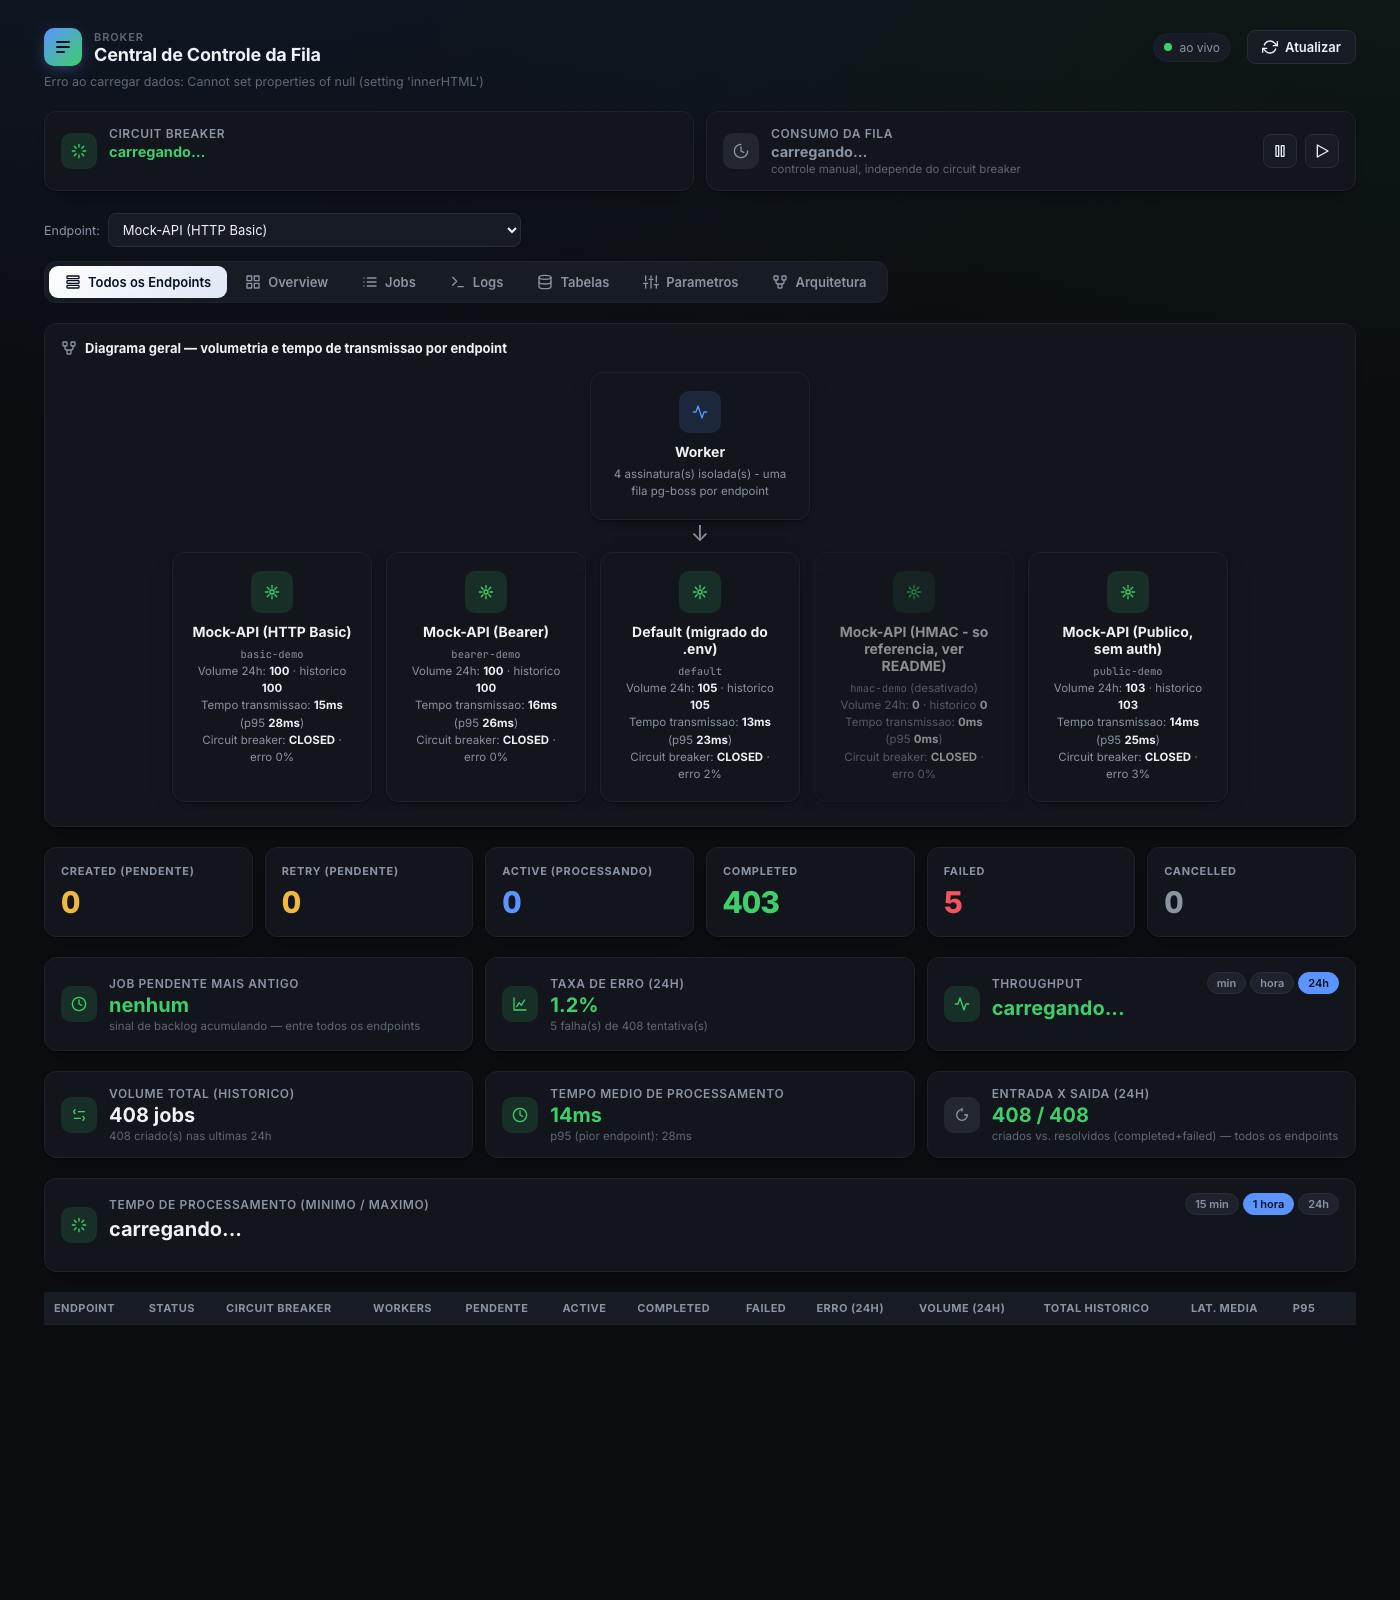
Todos os Endpoints (tela inicial)
Visão agregada de todas as integrações lado a lado: diagrama (Worker → cada endpoint), totais consolidados, e uma tabela com circuit breaker, contagem por estado, volume e latência de cada fila — inclusive quantos workers estão atribuídos a cada uma.
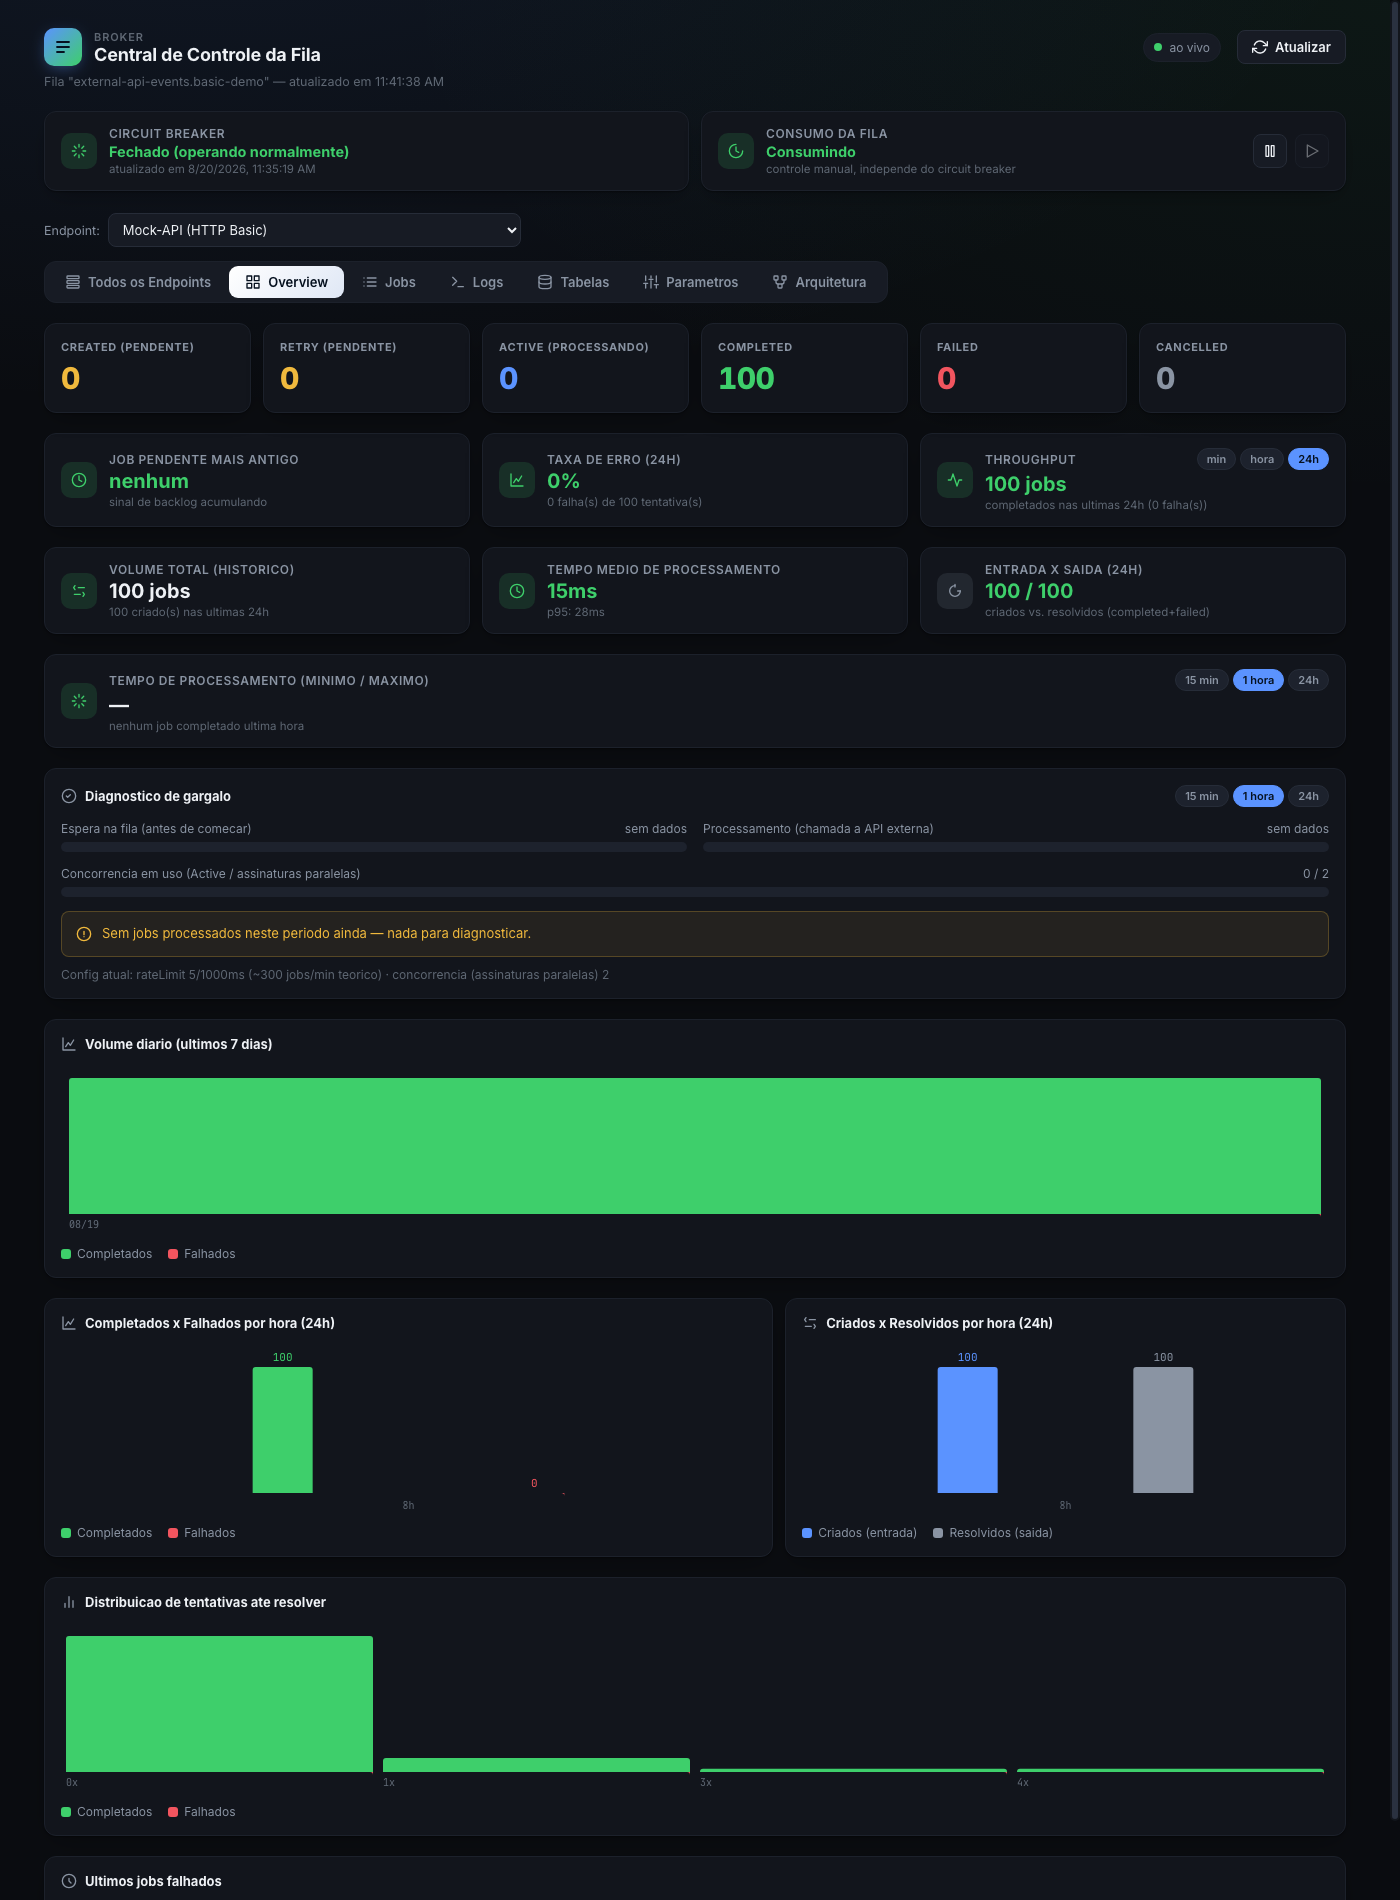
Overview (por endpoint)
Escopada pelo seletor de endpoint no topo: contagem por estado, circuit breaker, backlog, taxa de erro, throughput com seletor de período, gráficos de completados x falhados e criados x resolvidos, distribuição de retries, diagnóstico automático de gargalo (fila vs. API externa vs. rate limit).
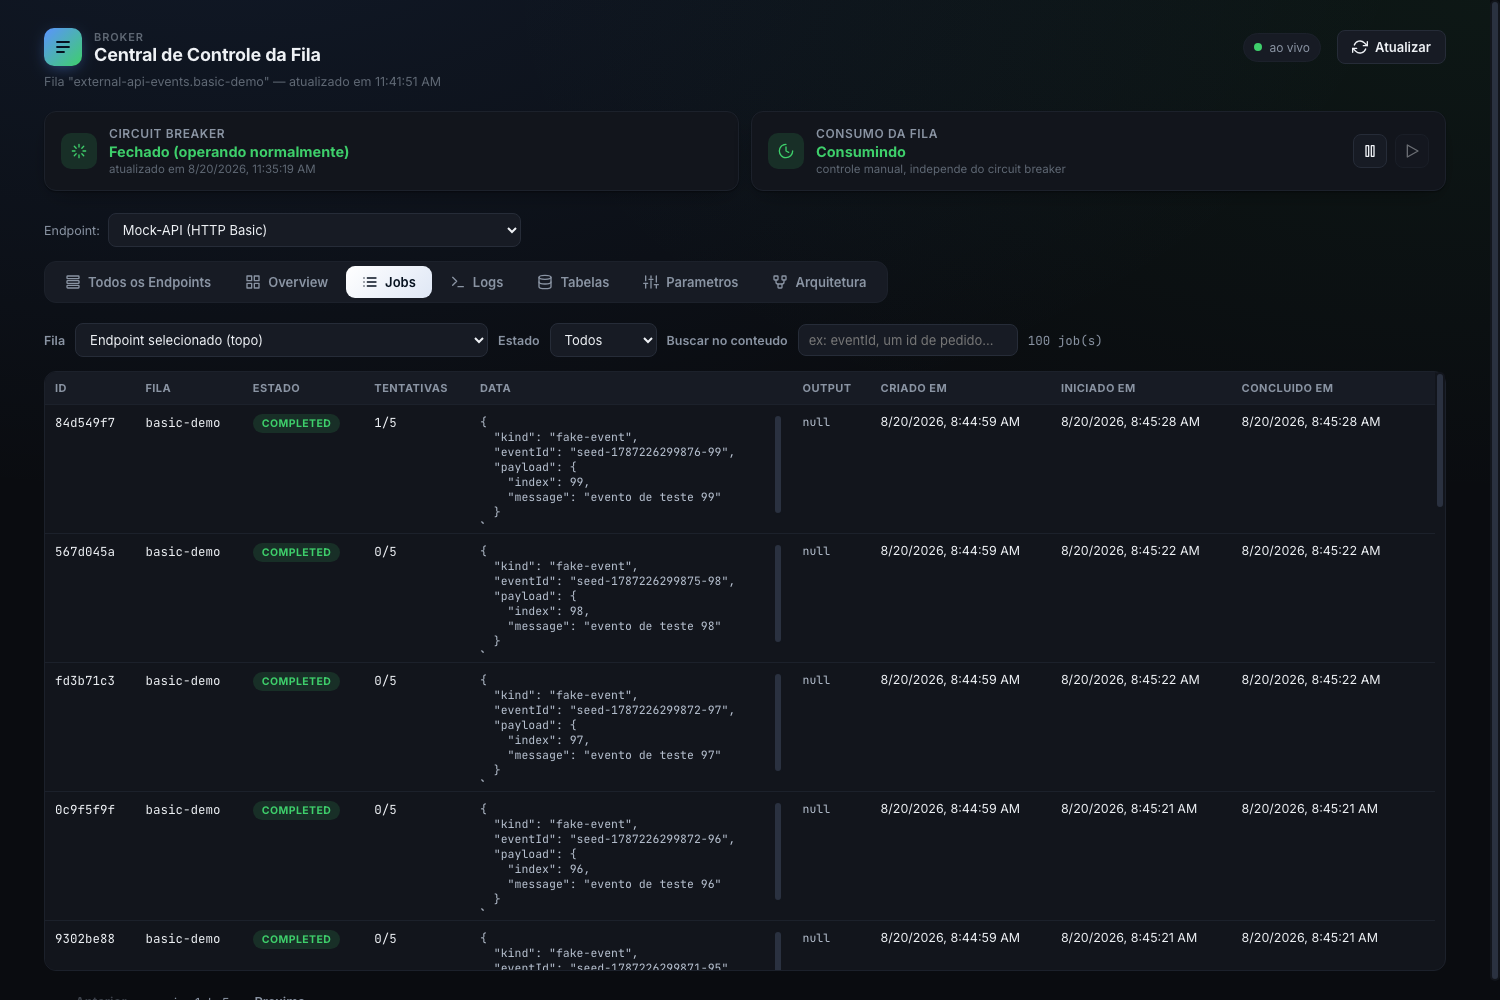
Jobs
Grid paginada com todos os jobs de qualquer estado. Filtro de Fila independente do
seletor do topo (endpoint selecionado, todas as filas juntas, ou uma específica), filtro por estado
e busca no conteúdo. Jobs failed podem ser reprocessados; created/retry
podem ser editados antes de rodar.
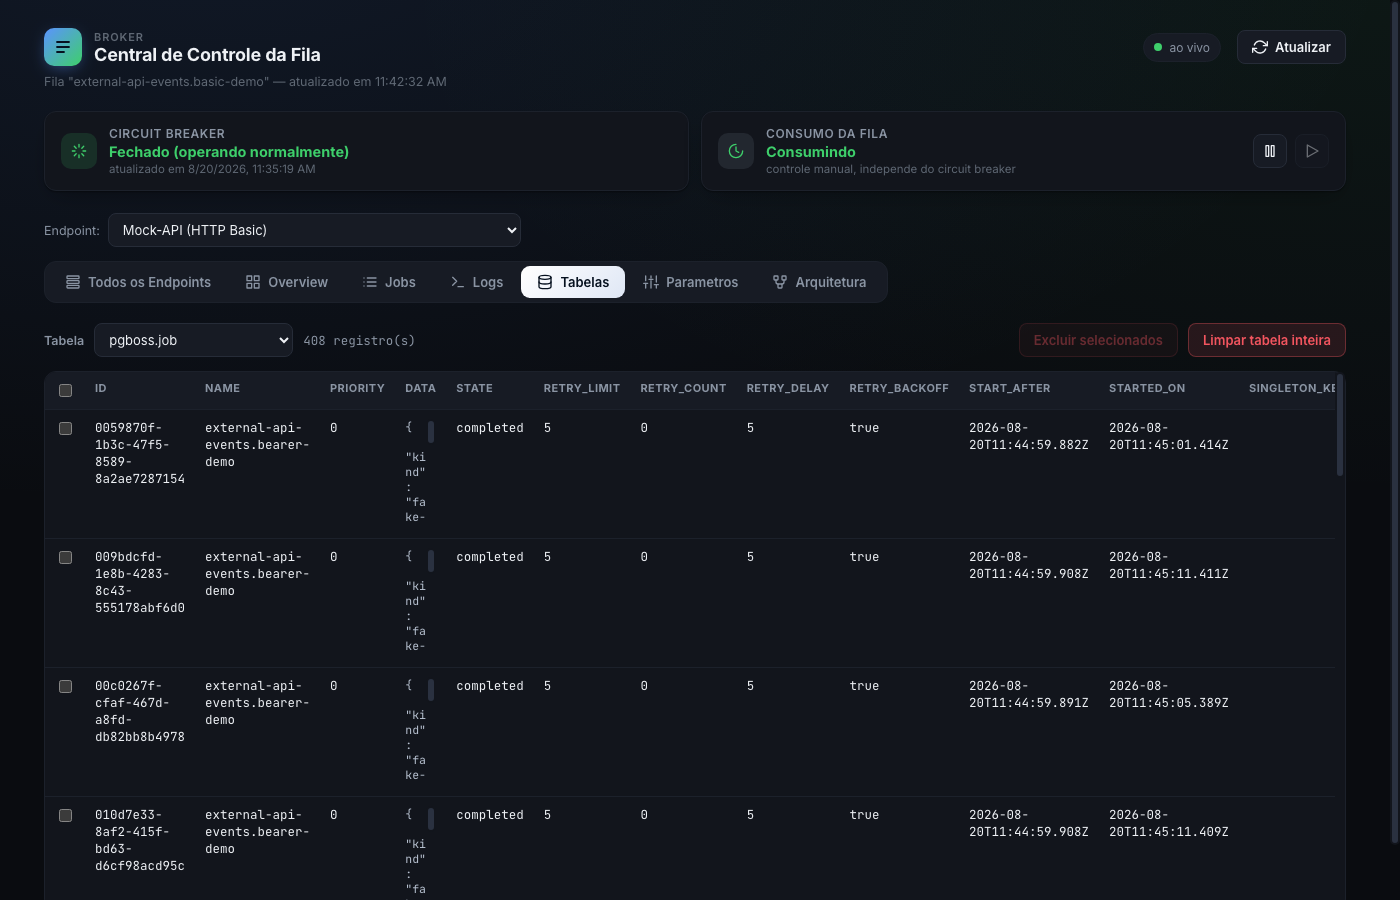
Tabelas
Browser genérico das tabelas internas do pg-boss e das tabelas próprias da aplicação. Tabelas com identidade única têm checkbox de seleção e os botões Excluir selecionados (protegido — nunca apaga jobs pendentes/em processamento) e Limpar tabela inteira (sem exceção).
Parâmetros
Edição em tempo real dos parâmetros globais (alertas, refresh do dashboard) e a seção de manutenção para limpar dados de teste. Gestão de endpoints, usuários e o envio de carga de teste ficaram numa aba própria — ver Admin — visível só para administradores.
Admin só administradores
Aba inteira invisível para o perfil user (nem aparece na barra de abas) — ver
Autenticação e controle de acesso. Reúne tudo que é gestão de
acesso/provisionamento, separado da aba Parâmetros (que ficou só com ajuste fino). Dividida
em 4 sub-seções (pills no topo da aba):
Endpoints
O mesmo CRUD que antes vivia em Parâmetros (criar, editar, ativar/desativar, excluir, gerar/regenerar chave de ingestão).
Usuários
Criar/excluir usuários do dashboard e definir o perfil (admin/user).
Laboratório
Duas ferramentas para testar o fluxo de ponta a ponta sem depender de uma API externa real:
- Mock-API — botão Subir mock-api/Encerrar
mock-api que sobe/derruba o processo
src/mock-api/server.jsdireto do dashboard (mesmo mecanismo dechild_process.spawnjá usado para escalar workers pela aba Arquitetura) — não depende mais do overlaydocker-compose.dev.ymlpara ligar/desligar, e funciona também em produção (restrito a admin) — o processo escuta em todas as interfaces, mas fica inacessível de fora pelo firewall/isolamento de rede do host, então dá pra manter ligado como um "endpoint de eco" real, útil pra exercitar circuit breaker/retry sem depender de terceiro. Botão Cadastrar endpoints de exemplo cria (via upsert, idempotente) os 5 endpoints de demonstração apontando pro mock-api, um por tipo de credencial — poupa criar cada um manualmente na aba Endpoints. - Enviar carga de teste — checklist com todos os endpoints
cadastrados (nome + status ativo/desativado, seleção múltipla, atalhos "todos"/
"nenhum"), um campo de quantidade (padrão 10, editável), botão
Enviar, e ao lado um contador ao vivo ("Na fila agora")
somando os jobs pendentes (
created+retry) só dos endpoints marcados — atualizado via SSE, sem polling próprio. Equivale aPOST /api/admin/seedcom{ count, endpointIds }, que devolve separadamente o que foi enfileirado (seeded) e o que foi ignorado (skipped, com o motivo) — um endpoint desativado não derruba o envio dos demais.
Agente de IA
Cadastro de qual LLM o chat flutuante vai usar — ver a seção dedicada abaixo.
Agente de IA (chat flutuante)
Um chat flutuante (ícone no canto inferior direito, disponível em qualquer aba, para
admin e user logados) que responde perguntas sobre o ambiente e
executa ações reais via linguagem natural — usando SOMENTE um conjunto curado de
tools, nunca SQL ou shell livre.
Vários modelos ao mesmo tempo, com failover por prioridade
Aba Admin → "Agente de IA" → CRUD simples: cadastre quantos modelos quiser, de qualquer combinação dos 7 provedores, cada um com uma prioridade (número menor = tentado primeiro) e um interruptor habilitado — só as linhas habilitadas entram na lista de failover, as demais ficam cadastradas mas fora de uso (botão Ativar/Desativar direto na lista, sem precisar excluir). Botão Testar conexão faz uma chamada mínima (sem tools, sem histórico) só pra validar credencial/URL — funciona mesmo numa config desativada, útil pra testar antes de habilitar de vez.
| Provedor | Campos |
|---|---|
| Claude (Anthropic) | chave de API, modelo (ex: claude-sonnet-5) |
| OpenAI | chave de API, modelo (ex: gpt-4o) |
| Azure OpenAI | chave de API, base URL do recurso, deployment, api-version |
| DeepSeek | chave de API, modelo |
| Grok (xAI) | chave de API, modelo |
| OpenAI (Responses API) | chave de API, modelo |
| Azure OpenAI (Responses API) | chave de API, base URL do recurso, deployment, api-version — obrigatório para deployments GPT-5.x, que não expõem Chat Completions |
input é uma lista plana de itens irmãos
message/function_call/function_call_output, sem
aninhamento por role). No Azure, a URL da Responses API não leva o deployment no path —
ele vai no corpo da requisição; erro clássico é colar a URL completa do "Responses
playground" do Azure (com /openai/responses?api-version=... já incluído) no
campo "Base URL", que deve conter só a raiz do recurso (ex:
https://seu-recurso.openai.azure.com)."Qual o melhor pra usar" é resolvido de forma 100% determinística, sem heurística nem uma segunda chamada de LLM só pra decidir: o agente sempre tenta o modelo de maior prioridade primeiro; só cai pro próximo habilitado se a chamada falhar de um jeito que justifique trocar (instabilidade do provedor — 5xx/429/timeout — ou credencial inválida daquela config específica — 401/403). Um erro de contrato (ex: schema de tool malformado, 400) não ativa failover — outro provedor tende a falhar do mesmo jeito, ou pior, aceitar silenciosamente algo que não devia.
tool_use gerado pelo provedor A não tem sentido
pro provedor B (formato/id são específicos de quem gerou). Se a falha ocorre no meio do
loop, a tentativa inteira daquele provedor é descartada (nunca
persistida) e o turno recomeça do zero, só com a mensagem original do usuário, no
próximo provedor da lista.AbortController) — sem isso, um provedor que trava sem responder e sem
fechar a conexão deixaria o turno inteiro pendurado indefinidamente, sem acionar failover
nenhum (achado real durante os testes desta funcionalidade, corrigido antes de virar
problema em produção).assistant(tool_calls) → tool(resultados). Numa
conversa longa o suficiente, o corte pode cair bem no meio de um desses pares, deixando a
janela começar com uma mensagem tool "órfã" — que provedores como a OpenAI
rejeitam ("messages with role 'tool' must be a response to a preceeding message with
'tool_calls'", achado real em produção). Corrigido ajustando a janela pro primeiro
limite de turno limpo (a mensagem user mais próxima), em vez
de confiar que o corte por contagem caiu num lugar seguro.A chave de API nunca é reexibida (mesmo padrão de authHeaderValue/senha de
usuário) — campo em branco ao editar mantém a chave atual. Trocar/adicionar/remover
modelos não quebra conversas em andamento — o histórico é guardado em
formato neutro, nunca no formato nativo de um provedor específico.
Instruções permanentes (o agente "aprendendo" sobre seu ambiente)
Aba Admin → "Agente de IA" → "Instruções permanentes do agente" — textos curtos
(título + conteúdo) injetados no system prompt de toda chamada,
pra ele ir ficando mais afiado sobre particularidades do seu ambiente (ex: "o endpoint
orders representa pedidos do site X", "sempre confirme antes de pausar uma
fila"). Cadastrar uma instrução com o mesmo título de uma existente
substitui o conteúdo (upsert) — corrigir uma instrução antiga nunca deixa
duas versões conflitantes convivendo no prompt.
remember() pra anotar algo sozinho durante a conversa. Ele já lê
dados de jobs/logs (potencialmente originados de APIs externas fora do seu controle)
dentro do mesmo loop de tool-calling; se pudesse "aprender" sozinho, um payload malicioso
poderia plantar uma instrução permanente que afeta todos os usuários daí
pra frente — prompt injection com efeito duradouro, não só na resposta de um turno.Todas as instruções cadastradas são injetadas (não só as N mais recentes), até um teto de 3000 caracteres — corta as mais antigas primeiro se estourar. Sem busca semântica nem ranking: pra um punhado de instruções curtas escritas por um admin, um orçamento de caracteres é mais previsível e mais fácil de auditar do que qualquer heurística de relevância.
Duas famílias de integração, não cinco adapters
OpenAI, Azure OpenAI, DeepSeek e Grok são Chat Completions (tools/
tool_calls) — reaproveitam o mesmo adapter, parametrizado só por URL/headers de transporte
(Azure muda pra {endpoint}/openai/deployments/{deployment}/chat/completions
?api-version=... com header api-key em vez de
Authorization: Bearer). Claude é a Messages API da Anthropic
(tool_use/tool_result em content blocks) — um segundo adapter,
genuinamente diferente no formato de mensagem.
Memória: uma conversa contínua por usuário
Sem conceito de "conversas" plurais (tipo abas do ChatGPT) — alinhado com o resto do
dashboard, que já usa sessão única por login. Histórico persistido em Postgres
(app_chat_messages), cortado nas últimas ~40 mensagens ao montar o prompt.
Botão lixeira no cabeçalho do chat apaga todo o histórico daquele usuário
(POST /api/assistant/clear) — sem confirmação não tem como desfazer.
Execução: tools curadas, nunca acesso livre
O modelo só enxerga um conjunto fixo de funções:
- Consulta (qualquer usuário logado): overview de endpoints, jobs, logs (worker/dashboard), lista de workers, diagnóstico de gargalo (espera na fila vs. tempo de chamada à API externa vs. saturação de concorrência — mesma análise já usada na aba Overview), throughput ao longo do tempo, distribuição de retries, e saúde do host/processo (carga de CPU, memória livre, pool de conexões do Postgres — útil quando a lentidão não está ligada a um endpoint específico).
- Ação (exigem
admin): pausar/retomar fila, popular fila de teste, CRUD de endpoint, CRUD de usuário, subir/encerrar instância de worker (add_worker/remove_worker— mesma ação do botão +/− da aba Arquitetura),update_endpointestendido (também corrigebaseUrl, credencial, e limites de rate limit/circuit breaker/retry, não só ativar/desativar) ereprocess_jobs(reenfileira jobs existentes — tipicamente falhados — como jobs novos com o mesmo payload, depois que a causa raiz foi corrigida). - Ideias/anotações pessoais (qualquer usuário logado):
save_idea/list_ideas/delete_idea— um bloco de notas do próprio usuário (app_agent_ideas, poruser_key). Digitar/registre <texto>no chat salva direto no banco sem chamar nenhuma LLM (funciona mesmo sem provedor configurado); pedir em linguagem natural ("registra essa ideia: ...", "quais ideias eu tenho?", "apaga a ideia 3") passa pelas tools normalmente. Nunca é compartilhado entre usuários nem injetado em prompt nenhum — só volta pro chat quando o próprio usuário pede pra listar, ao contrário das "instruções permanentes" de admin abaixo.
processingMs no diagnóstico de gargalo, e
avgProcessingMs/p95ProcessingMs no overview) — isso já inclui
rede + tempo de resposta da API externa somados. Não há (ainda) uma quebra fina entre
DNS/conexão TCP/TTFB isolados; isso exigiria instrumentar o ExternalApiClient
por etapa, um passo além do que existe hoje.PGBOSS_POLLING_INTERVAL_SECONDS=0.5, o
mínimo aceito pelo pg-boss) dominando o tempo de espera de uma fila tipicamente vazia; ou
um pico passageiro de jobs que já terminou de processar antes da
consulta, mas ainda pesa na média da janela. Tanto o painel da aba Overview quanto a tool
get_bottleneck_diagnosis do agente apresentam as duas hipóteses em vez de
cravar "aumente a concorrência" quando os slots estão ociosos no momento — esse conselho
só ajuda no segundo caso.Cada tool chama a mesma função que a rota HTTP equivalente já chama —
nunca uma lógica paralela — e reforça a mesma checagem de role do resto do
dashboard antes de executar; se um usuário user pedir uma ação restrita, a
tool devolve erro de permissão pro modelo relatar, sem exceção. O modelo encadeia tools
sozinho quando precisa (ex: "encerre o último worker criado" primeiro chama
list_workers, depois remove_worker com o id certo).
"Ver raciocínio": qual IA respondeu e o que ela fez
Nenhum provedor expõe o chain-of-thought interno do modelo via API — o que dá pra mostrar
de forma honesta é o que a IA de fato fez, não "o que ela pensou". Cada
resposta do assistente traz um link "ver raciocínio (N passos)" que
expande, por tool chamada nessa resposta: nome da tool, argumentos enviados e resultado
recebido — e uma etiqueta "via <provedor>" mostrando qual das
configs de LLM cadastradas de fato respondeu (relevante porque pode haver failover entre
várias, ver acima). Isso é persistido junto do histórico neutro
(app_chat_messages.provider) e reconstruído igual tanto numa resposta que
acabou de chegar quanto ao reabrir o chat depois — a mesma trilha, sempre.
Gráficos "quando necessário"
O modelo decide quando um número/série ajuda a resposta e chama a tool estruturada
render_chart({type, title, labels, series}) — o front-end desenha em
<canvas> (mesmo estilo dos gráficos já usados no resto do dashboard),
sem trazer uma biblioteca de gráficos nova e sem risco de HTML/JS livre injetado no chat.
Fluxos (módulo opcional de regras visuais, tipo n8n)
Aba Admin → "Fluxos". Um fluxo visual por endpoint (não uma biblioteca de
fluxos compartilhados) que filtra e transforma o payload de um job antes
dele seguir pra API externa já configurada daquele endpoint — sem escrever código,
conectando nós num canvas. Deliberadamente opcional e contido: um endpoint
sem fluxo publicado se comporta exatamente como se o módulo não existisse — mesmo código,
mesma performance, zero query extra por job (getPublishedGraph em
src/config/flows.js só é consultado, mas retorna null imediatamente
se o endpoint nunca teve nada publicado).
solution-architect e
integration-architect antes de implementar, e revisitada quando o escopo
cresceu (acesso a banco externo, caminho de arquivo dinâmico, leitura/escrita em fila) —
cada expansão foi uma escolha explícita, ciente do trade-off de segurança envolvido, não
um "já que estamos aqui".Tipos de nó
A barra lateral do editor agrupa os nós em 5 categorias:
- Fluxo —
filter(deixa passar ou encerra o job ali mesmo: "filtrado" é uma decisão de negócio, nunca uma falha),branch(if/else, duas saídas),set-field(escreve um valor num campo, cria caminho aninhado se precisar) edefault-value(só escreve se o campo estiver ausente/nulo). - Controle de fluxo —
split/merge: manda o mesmo payload por duas vias ao mesmo tempo (de verdade em paralelo, viaPromise.all— se cada via faz uma consulta de banco/arquivo, o tempo de espera se sobrepõe) e depois combina os dois resultados num payload só. As duas vias precisam terminar no mesmo nómerge; em campo com o mesmo nome nas duas, a via B vence (regra fixa, sempre o mesmo resultado). - Banco de dados —
db-query: consulta um Postgres externo (conexão cadastrada em "Gerenciar conexões", credencial nunca reexibida). Modosselect-one/select-many/execute(INSERT/UPDATE/DELETE). - Arquivos —
read-file: lê um arquivo de referência (json/csv/lines/kv) pra enriquecer o payload, comlookupFieldopcional pra achar 1 linha específica numa lista. - Filas existentes —
enqueue(manda o payload atual pra fila de outro endpoint já cadastrado) equeue-stats(lê as contagens dessa fila — pendentes, ativos, etc).
enqueue pro MESMO endpoint que tem esse fluxo
publicado — o job novo cairia na mesma fila, seria pego pelo mesmo fluxo, e
reenfileiraria de novo indefinidamente (loop de amplificação de jobs). Use
enqueue pra encaminhar pra um endpoint diferente.Fora de escopo, de propósito (pra não virar um n8n inteiro dentro do
broker): nó de chamada HTTP arbitrária dentro do fluxo, fan-out pra múltiplos jobs, loop,
delay, agendamento, sub-fluxos. Cada um tem uma razão arquitetural específica documentada
em src/flows/engine.js — não é "ainda não deu tempo".
Sem eval, de propósito — cada expansão com sua própria defesa
O payload de um job vem de um produtor externo — tratado como dado em
toda a execução, nunca como instrução a interpretar (mesmo princípio já aplicado ao agente
de IA). Cada tipo de nó é interpretado por código fixo; acesso a campo é só por dot-path
(customer.regiao, e também dentro de array:
items.0.a).
db-query: a SQL é escrita pelo admin (mesma confiança de qualquer outra config do dashboard); valores vindos do payload só entram como parâmetro ligado ($1,$2...), nunca concatenados na string — testado manualmente com um valor de payload contendo' OR '1'='1pra confirmar que é tratado como dado literal, não como SQL. Timeout de 5s fixo, pool próprio por conexão.read-file: o caminho pode vir de um campo do payload (dinâmico), mas o resultado final é sempre travado dentro deFLOW_FILES_DIR(padrão./data/flow-files) — testado manualmente que tanto../../etc/passwdquanto/etc/passwdsão rejeitados, porque o caminho resolvido cai fora do diretório permitido, não porque o texto "parece perigoso".enqueueno modo "Testar"/"Rodar este nó": nunca envia de verdade (dryRunEnqueue) — só mostra o que teria sido enviado, pra testar um fluxo nunca poluir uma fila real.
Cada nó mostra entrada/saída, com play próprio
Todo card do canvas tem 3 áreas lado a lado: entrada (esquerda, JSON
editável), configuração + botão "Rodar" (meio) e saída
(direita, resultado). O dado atravessa o card da esquerda pra direita, na mesma direção das
portas de conexão (entrada na borda esquerda, saída na direita). Clicar em "Rodar" executa
só aquele nó (POST /api/admin/flows/:endpointId/run-node,
runSingleNode em src/flows/engine.js) contra o JSON da coluna de
entrada — não precisa do resto do grafo nem publica nada. start também tem
botão de rodar (digite um payload de exemplo e "alimente" o primeiro nó real da cadeia
manualmente); só split/merge não têm, porque dependem
estruturalmente das duas vias do grafo.
- Saída de um nó vira entrada do próximo automaticamente — ao rodar um nó com conexão de saída, o resultado pré-preenche a entrada do nó seguinte na hora, sem copiar/colar manualmente.
- Navegar o JSON clicando — tanto entrada quanto saída mostram os campos como "pills" clicáveis; clicar insere aquele caminho no campo de texto que estava focado por último em qualquer outro nó — é como levar um valor de um nó pra outro, por clique em vez de arrastar o valor em si.
- Conectar arrastando — cada nó tem uma bolinha de entrada (esquerda) e uma ou duas de saída (direita); arrastar de uma até o card de outro nó cria a conexão (soltar em qualquer parte do card basta). O seletor "vai para" dentro do nó faz a mesma coisa, os dois nunca dessincronizam.
Versionamento, publicação e simulação do fluxo inteiro
Publicar nunca apaga a versão anterior — só troca qual está ativa. O editor sempre mostra/edita o rascunho (última versão salva, publicada ou não). Publicar/despublicar tem efeito no próximo job, sem reiniciar o worker. "Simular/depurar passo a passo" roda o rascunho inteiro contra um payload de exemplo, sincronamente, sem criar job na fila — cada passo do resultado mostra o payload antes/depois daquele nó, clicável, e clicar num passo realça o nó correspondente no canvas.
Falhas nunca contaminam o circuit breaker
Um erro de fluxo (campo obrigatório faltando, tipo de nó mal configurado) é sempre um bug
de lógica/dado, nunca evidência de degradação da API externa — o mesmo
isPermanentFailure que já tratava um 4xx de contrato quebrado em
src/worker/processor.js reconhece esse tipo de erro e nunca alimenta o circuit
breaker do endpoint. Um job filtrado termina como sucesso (nunca chama a
API externa, nunca conta como falha).
Execuções
Produção e teste ficam em app_flow_execution — payload de entrada/saída,
status (ok/filtered/error), trilha por nó e
duração, mesmo espírito do "ver raciocínio" do agente de IA: mostrar exatamente o que
aconteceu, não uma suposição. Cada linha tem um botão de excluir, e "Limpar execuções"
apaga todo o histórico daquele endpoint de uma vez — nunca afeta rascunho, versão publicada
ou jobs reais na fila.
Arquitetura (ao vivo)
Diagrama animado: Dashboard → Postgres → Worker(s) → API Externa, com o estado real do circuit breaker, slots de concorrência ocupados, e a lista de todas as instâncias de worker vivas — cada uma com suas filas atribuídas e os botões + (subir novo worker) e − (encerrar uma instância específica).
Autenticação e controle de acesso
O dashboard inteiro fica atrás de login. Dois perfis:
| Perfil | Pode |
|---|---|
| admin | Tudo — CRUD de endpoints, gerenciar usuários, gerar/regenerar chaves de ingestão, editar parâmetros globais, botão de teste (seed), Swagger, pausar/retomar consumo, excluir/limpar tabelas, subir/derrubar workers. |
| user | Somente leitura — Overview, Jobs, Logs, Tabelas (visualizar), Todos os Endpoints, Arquitetura. Qualquer tentativa de escrita retorna 403, reforçado no servidor (o front-end só esconde os botões, não é a barreira de segurança real). |
Usuário master
Existe um usuário "master" sempre disponível, independente do que
estiver cadastrado em app_users — vem de variáveis de ambiente e nunca
é gravado como linha comum na tabela:
ADMIN_USERNAME=julio      # default se omitido do .env
ADMIN_PASSWORD=102938 # default se omitido - TROQUE em producaoapp_users — é o acesso de emergência da aplicação. Não dá pra criar um usuário chamado julio pela aba Admin (nome reservado).Sessão e senha
- Sessão em Postgres (tabela
app_sessions, cookieHttpOnly, 24h) — não é um cookie assinado sem estado. Isso importa porque permite revogar na hora: quando um admin exclui um usuário, a sessão dele morre imediatamente, não só quando o cookie expira sozinho. - Senha com
crypto.scryptSyncnativo do Node (memory-hard, resistente a GPU/ASIC) — sem trazer bcrypt/argon2 como dependência nova só por causa disso. Comparação sempre viatimingSafeEqual.
Gerenciar usuários
Aba Admin → "Usuários do dashboard", ou via API:
GET    /api/users                       (admin)
POST   /api/users        { username, password, role }   (admin)
DELETE /api/users/:id                                     (admin - revoga a sessao na hora)
Tokens de ingestão continuam por-endpoint
Decisão deliberada: não criamos um segundo mecanismo de token
por-usuário. Cada endpoint já é uma fila isolada — "1 token = 1 endpoint" já dá o
isolamento certo (comprometer uma chave expõe só aquela fila, não várias). O que mudou
com o login: gerar/regenerar a X-Ingest-Key agora exige sessão de
admin, e fica registrado quem gerou (coluna
ingest_key_created_by, visível na aba Admin) — auditoria sem duplicar
o mecanismo de autenticação. Ver API HTTP de ingestão.
Swagger (admin)
Link no menu Ajuda (só aparece logado como admin) →
/admin/swagger.html — Swagger UI carregada via CDN, documentando
só a API de ingestão (POST /api/ingest/:endpointId e o
endpoint de regeneração de chave). É o único contrato que um sistema externo de fato
consome; o resto do dashboard é operação interna do próprio time, não vale a pena
formalizar em OpenAPI. O spec (GET /api/openapi.json) também exige sessão
de admin — a página HTML em si carrega pra qualquer um, mas fica vazia/nega acesso sem
um fetch autenticado bem-sucedido.
Botão de teste (seed)
Aba Admin → "Enviar carga de teste" — checklist de endpoints (seleção
múltipla, mostra nome + status ativo/desativado), campo de quantidade (padrão 10) e um
contador ao vivo de jobs pendentes nos endpoints marcados. Mesma lógica de
scripts/seed.js, mas roda dentro do processo do dashboard
(reaproveitando o sendBoss já existente ali para reprocessamento), sem subir
um subprocesso. Equivale a POST /api/admin/seed (admin-only), que aceita
{ count, endpointIds } no corpo — sem eles, usa 10 jobs em todos os endpoints
habilitados; endpoints desativados ou inexistentes na lista voltam em skipped
em vez de derrubar a chamada inteira. Ver tela Admin.
Segurança e boas práticas
- Credenciais nunca são reexibidas.
authHeaderValueé write-only — a API só retorna{configured: true/false}. - Postgres dedicado. Não compartilhar a instância com outras aplicações.
- Sem socket do Docker no dashboard. O botão "+" de subir worker roda um processo filho dentro do próprio container do dashboard, deliberadamente — não monta o socket do Docker, que daria ao dashboard controle total sobre containers do host.
- Exclusão de tabelas é protegida por padrão.
pgboss.jobnunca é apagado em estado pendente/ativo pela grid, exceto na ação explícita "Limpar tabela inteira". - mock-api nunca em produção — trava por
NODE_ENVe por estar isolado num overlay de compose separado.
Sobre esta documentação
Esta página (src/dashboard/public/docs.html) é servida pelo próprio dashboard —
acessível pelo menu Ajuda → Documentação no cabeçalho. Ela é parte do
código do projeto, não um documento à parte: toda vez que a arquitetura, as telas ou o
processo de configuração mudarem, esta página deve ser atualizada na mesma alteração (mesmo
princípio já seguido para o README.md).
Os screenshots em docs-assets/ foram capturados via Chrome headless
(--headless --screenshot) direto da instância local rodando — para atualizá-los depois
de uma mudança visual relevante:
"/Applications/Google Chrome.app/Contents/MacOS/Google Chrome" \
  --headless --disable-gpu --window-size=1400,1000 \
  --screenshot=src/dashboard/public/docs-assets/overview.png \
  "http://localhost:8080/#overview"
Trocando #overview pela aba desejada (#all-endpoints, #jobs,
#tables, #params, #architecture) — o hash na URL já aciona a
troca de aba automaticamente (mesmo mecanismo usado por link direto no dashboard).